답변

이벤트 전파(Event Propagation)는 브라우저에서 이벤트가 발생했을 때, 이벤트가 DOM 트리를 따라 이동하는 방식을 의미합니다.
크게 캡쳐링(Capturing), 버블링(Bubbling) 두 단계가 있으며, 이벤트 위임(Event Delegation)은 이 특성을 활용하는 기법입니다.

키워드 설명

  • 캡쳐링(Caturing Phase)
    • 이벤트가 최상위 document 에서 시작해 목표 요소까지 내려오는 단계입니다.
    • 기본적으로 JS에서 이벤트 리스너를 등록할 때 addEventListener 의 세 번째 인자를 true 로 설정하면 캡쳐링 단계에서 이벤트를 잡을 수 있습니다.
    parent.addEventListener('click', () => {
    	console.log('캡쳐링 단계에서 부모 클릭!');
    }, true);
    
  • 버블링(Bubbling Phase)
    • 이벤트가 목표 요소에서 발생한 후, 부모 요소로 거슬러 올라가는 단계입니다.
    • 대부분의 이벤트는 기본적으로 버블링을 지원하며, 세 번째 인자를 생략하거나 false 로 설정하면 버블링 단계에서 이벤트를 잡습니다.
    parent.addEventListener('click', () => {
    	console.log('버블링 단계에서 부모 클릭!');
    });
    
  • 이벤트 위임(Event Delegation)
    • 자식 요소 각각에 이벤트를 등록하는 대신, 공통 부모 요소 하나에 이벤트를 등록하고 이벤트 버블링을 이용해 처리하는 기법입니다.
    • 장점: 메모리 절약, 동적으로 생성되는 요소에도 이벤트 적용 가능
    const list = document.querySelector('ul');
    list.addEventListner('click', (e) => {
    	if(e.target.tagName == 'LI') {
    		console.log(`${e.target.textContent} 클릭됨`);
    	}
    });
    

꼬리질문

  1. 버블링과 캡쳐링의 순서를 그림으로 설명해보세요.
    • 부모 → 자식 순으로 내려가면 캡쳐링, 자식→ 부모 순으로 올라가면 버블링입니다.
  2. 이벤트 위임 시 e.target과 this(currentTarget)의 차이를 설명해보세요.
    • e.target은 실제 클릭된 자식, this는 이벤트 리스너가 붙은 부모 요소입니다.
  3. 버블링을 막고 싶다면 어떻게 해야 하나요?
    • e.stopPropagation()을 사용하면 더 이상 부모로 이벤트가 전파되지 않습니다.
  4. 동적으로 생성된 요소에도 이벤트를 적용하려면?
    • 이벤트 위임을 사용하면, 부모에 이벤트를 걸어 동적으로 생성된 자식 요소도 이벤트를 처리할 수 있습니다.

답변

자바스크립트는 동적 타입 언어로, 변수의 타입이 실행 중에 변경될 수 있습니다.
원시 타입과 참조 타입이 있으며, 필요에 따라 JS 엔진이 타입을 자동으로 변환하는 타입 강제(Type Coercion)가 발생합니다.
- 원시 타입: String, Number, BigInt, Boolean, undefined, null, Symbol
- 참조 타입: Object, Array, Function 등
타입 변환은 암묵적(자동) 또는 명시적(개발자가 직접)으로 발생할 수 있으며, 비교 연산 시 주의가 필요합니다.

키워드 설명

  • 암묵적 타입 변환(Implicit Coercion): JS 엔진이 자동으로 타입을 변환
"5" + 3 // "53 
// -> +연산자는 덧셈과 문자열연결 2가지 역할을 함
// ->피연산자 중 하나가 문자열이면, JS는 다른 피연산자도 문자열로 자동 변환해서 연결

"5" - 3 // 2
// -> -연산자는 덧셈이 아닌 산술 연산
// -> JS는 산술 연산을 수행하기 위해 피연산자를 숫자형으로 자동 변환
// -, *, /, % 같은 산술 연산자는 항상 숫자형 연산을 수행하므로 문자열을 숫자로 변환
true + 1 // 2
  • 명시적 타입 변환(Explicit Coercion): 개발자가 직접 변환
Number("123")
String(123)
Boolean(0)
parseInt("42px")
  • Falsy 값: 0 , "" , null , undefined , NaN , false
  • Truthy 값: 나머지 모든 값
  • === vs ==: === 는 타입까지 비교, == 는 타입 변환 후 비교

꼬리질문

  1. 0 == “0” 과 0 === "0" 의 결과 차이는 무엇인가요?
    • 0 == "0" → true (문자열 “0”이 숫자 0으로 변환됨)
      • == 연산 시, 한쪽이 숫자이고, 다른 쪽이 문자열이면, 문자열을 숫자로 변환
    • 0 === "0" → false (타입이 다름)
  2. null == undefined 와 null === undefined 의 결과는 무엇인가요?
    • null == undefined → true (암묵적 타입 변환)
      • JS 사양에 정의되어 있는 규칙
    • null === undefined → false (타입이 다름)
  3. Boolean 변환 시 falsy 값과 truthy 값을 예시로 들어보세요.
    • falsy: 0, "", null, undefined, NaN, false
    • truthy: "hello", 1, [], {}, function(){}
  4. 타입 변환에서 주의할 점은 무엇인가요?
    • 암묵적 타입 변환은 예기치 않은 결과를 초래할 수 있으므로, 비교 시 === 사용을 권장하며, 명시적 변환을 통해 의도를 명확히 하는 것이 좋습니다.

답변

실행 컨텍스트(Execution Context)는 자바스크립트 코드가 실행되기 위해 필요한 정보(변수, 스코프, this, 환경)를 모아둔 실행 환경 객체입니다.
함수나 전역 코드가 실행될 때마다 새로운 실행 컨텍스트가 생성되어 콜스택(Call Stack)에 쌓이고, 자바스크립트는 이 컨텍스트를 기반으로 변수 조회, 스코프 결정, this 바인딩 등을 수행합니다.
즉, 실행 컨텍스트는 “코드가 어떻게 동작할지 결정하는 모든 정보”를 담고 있는 구조입니다.

키워드 설명

  • 실행 컨텍스트에 포함되는 핵심 요소
    • Lexical Environment (렉시컬 환경)
      • let/const 선언
      • 환경 레코드(Environment Record)
      • 스코프 체인 정보
    • Variable Environment (변수 환경)
      • var 선언 정보
      • 초기 스코프 정보
    • This Binding
      • 해당 컨텍스트에서 this가 무엇을 가리키는지 저장
  • 실행 컨텍스트 종류
    • 전역 실행 컨텍스트
      • 자바스크립트 코드 최초 실행 시 생성
      • 전역 스코프 & 전역 객체(window/global) 연결
    • 함수 실행 컨텍스트
      • 함수가 호출될 때마다 생성
      • 함수 내부 변수/매개변수/스코프 정보 저장

실행 컨텍스트 동작 과정 (필수 2단계)

  1. 생성 단계 (Creation Phase)
    • 환경 구성 (렉시컬/변수 환경 생성)
    • 변수 및 함수 선언을 메모리에 등록
    • 호이스팅 발생
    • var → undefined로 초기화
    • let/const → TDZ에 들어감
    • this 바인딩 결정
  2. 실행 단계 (Execution Phase)
    • 코드가 실제 실행됨
    • 변수에 값 할당, 함수 호출 등 수행됨

코드 예시

  • 예시 1 - 전역 + 함수 실행 컨텍스트
var x = 1;

function foo() {
	var y = 2;
	console.log(x + y);
}

foo();

/*
1. 전역 실행 컨텍스트 실행
	- x, foo가 메모리에 등록됨(호이스팅)
2. foo()호출 -> 함수 실행 컨텍스트 생성
	- y 등록
3. foo 컨텍스트 종료 -> 스택에서 제거
*/
  • 예시 2 - 렉시컬 환경 & 스코프 체인
let a = 1;

function outer() {
	let b = 2;
	
	function inner() {
		let c = 3;
		console.log(a, b, c);
	}
	innter();
}
outer();

/*
inner Lexical Environment
		↓
outer Lexical Environment
		↓
global Lexical Environment
*/

실행 컨텍스트 구조 그림

Execution Context
├─ Lexical Environment
│   ├─ Environment Record
│   └─ Outer Environment Reference
├─ Variable Environment
└─ This Binding

꼬리질문

  1. 실행 컨텍스트 생성 시 어떤 일이 발생하나요?
    • 스코프 환경 생성
    • 변수/함수 선언 등록 → 호이스팅
    • this 바인딩 결정
    • 부모 환경(스코프 체인) 연결 → 이후 실행 단계에서 코드 실행 
  2. 스코프 체인과 실행 컨텍스트의 관계는?
    • 실행 컨텍스트 내부의 Lexical Environment들이 계층적으로 연결된 구조가 스코프 체인입니다.
    • 각 함수가 생성될 때 자신의 상위 환경을 기억하기 때문에 inner → outer → global 순으로 변수 탐색이 가능합니다.
  3. 클로저와 실행 컨텍스트의 관계는?
    • 클로저는 내부 함수가 상위 실행 컨텍스트의 변수를 실행이 끝난 이후에도 계속 참조할 수 있는 현상입니다.
    • 즉, 상위 Lexical Environment가 GC되지 않고 유지된 채 내부 함수와 연결되어 있는 상태입니다.
  4. 실행 컨텍스트와 콜스택은 같은건가요?
    • 둘은 다릅니다.
      • 실행 컨텍스트: 실행 환경 자체
      • 콜스택: 그 실행 컨텍스트를 쌓는 자료구조

답변

자바스크립트에서 프로토타입(Prototype)은 객체가 다른 객체의 속성과 메서드를 상속(공유)받기 위한 메커니즘입니다.
모든 객체는 내부적으로 [[Prototype]]이라는 숨겨진 슬롯을 가지고 있고, 이 슬롯이 다른 객체를 참조하면서 프로토타입 체인(Prototype Chain)을 형성합니다.
어떤 프로퍼티를 찾을 때 현재 객체에 없으면, 이 프로토타입 체인에 따라 상위 객체에서 계속 탐색합니다.

키워드 설명

  • Prototype(프로토타입)
    • 자바스크립트의 상속 구조를 구현하는 방식
    • 모든 객체는 [[Prototype]]이라는 내부 슬롯을 가짐
    • 이는 연결된 다른 객체를 가리킴
  • 프로토타입 체인(Prototype Chain)
    • 객체가 특정 프로퍼티를 가지지 않으면 자신의 프로토타입 → 그 상위 프로토타입 → … → Object.prototype 순으로 탐색하는 구조
  • __proto__ vs prototype
    • __proto__
      • 객체 인스턴스가 가지고 있는 실제 프로토타입 참조
    • prototype
      • 함수 객체만 가지는 프로퍼티로, 해당 함수를 new로 호출했을 때 생성되는 객체의 프로토타입이 됨
  • new 바인딩과 프로토타입
    • new 로 객체를 생성하면 다음 일이 발생함:
      • 새로운 빈 객체 생성
      • 새 객체의 [[Prototype]] 을 함수의 prototype 과 연결
      • 객체 반환

코드 예시

  • 프로토타입 체인
const parent = {
  sayHello() {
    console.log("hello");
  }
};

const child = Object.create(parent);

child.sayHello(); // "hello"
  • 생성자 함수와 prototype
function User(name) {
  this.name = name;
}

User.prototype.sayHi = function() {
  console.log("Hi, " + this.name);
};

const u = new User("Yong");
u.sayHi(); // "Hi, Yong"

// 이때 구조는:
u.__proto__ === User.prototype
User.prototype.__proto__ === Object.prototype
  • __proto__ vs prototype 차이
function Car() {}
const myCar = new Car();

console.log(myCar.__proto__ === Car.prototype); // true

꼬리질문

  1. 프로토타입 체인을 설명해주세요.
    • 객체에서 특정 프로퍼티를 찾을 때 현재 객체에 없으면 [[Prototype]]이 가리키는 상위 객체를 따라 계속 탐색하는 구조를 말합니다.
    • 이 연결 구조를 프로토타입 체인이라고 하며, 끝은 항상 Object.prototype이고, 그 위는 null입니다.
  2. __proto__와 prototype의 차이는 무엇인가요?
    • __proto__는 실제 객체 인스턴스가 가진 프로토타입 참조이고, prototype은 함수 객체가 가지는 프로퍼티로 해당 함수를 new로 호출했을 때 새 객체의 프로토타입이 됩니다.
    • 즉, obj.__proto__ → 인스턴스가 참조하는 프로토타입, Func.prototype → 인스턴스의 프로토타입이 될 객체
  3. new 키워드가 내부적으로 무엇을 하는가요?
    • new는 다음 4단계를 내부적으로 수행합니다:
      • 빈 객체 생성
      • 이 객체의 [[Prototype]]을 생성자 함수의 prototype과 연결
      • this를 새 객체로 바인딩하여 함수 실행
      • 명시적 return이 없으면 새 객체 반환

답변

자바스크립트는 싱글 스레드 언어이기 때문에 한 번에 한 작업만 처리할 수 있습니다.
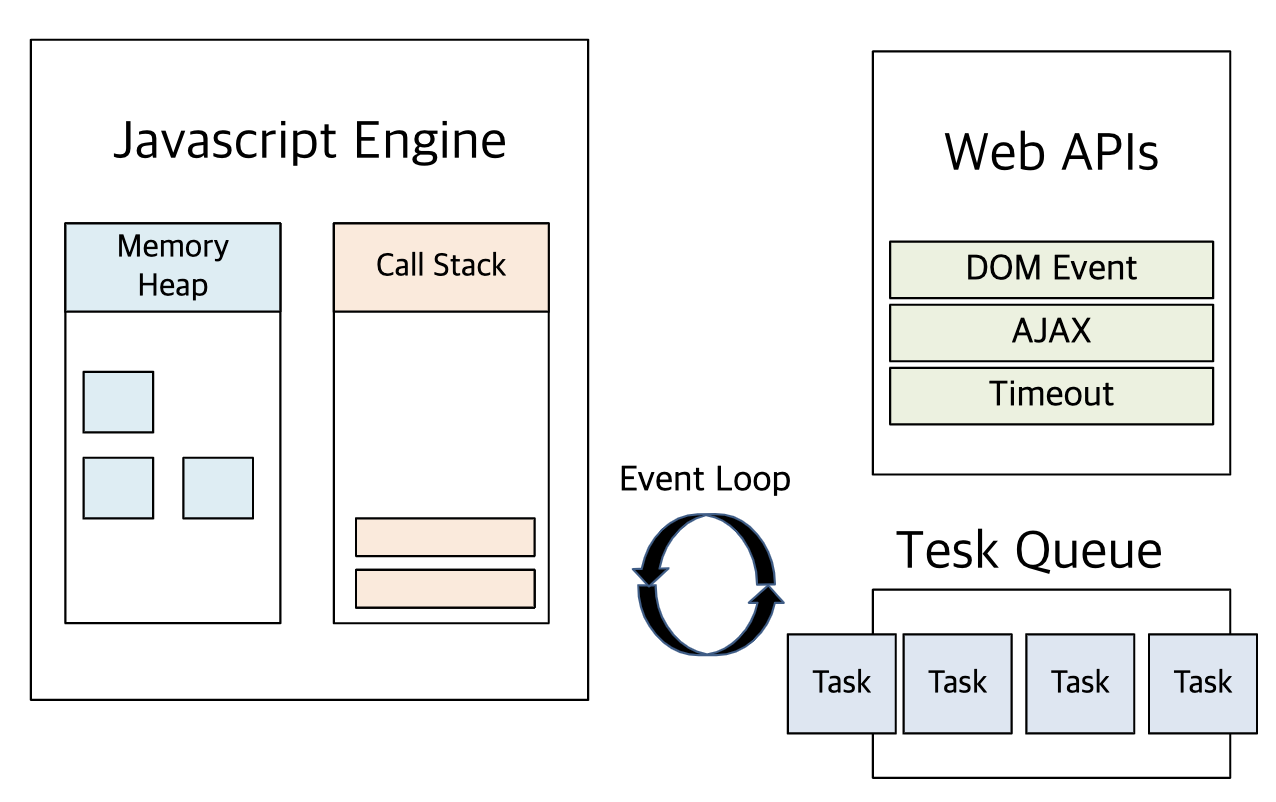
이벤트 루프는 콜스택과 테스크 큐를 감시하면서, 콜스택이 비는 시점에 큐에 있는 콜백을 가져와 실행함으로써 비동기 작업을 가능하게 하는 매커니즘입니다.

키워드 설명

  • Calll Stack (콜스택)
    • 실행 중인 함수들이 쌓이는 곳
  • Web APIs (브라우저) / Node APIs
    • setTimeout, DOM 이벤트, fetch 같은 비동기 작업을 처리하는 공간 → JS 엔진이 직접 하는 게 아니라 브라우저가 담당
  • Task Queue / Microtask Queue
    • 작업 완료된 콜백이 대기하는 곳
      • Microtask queue: Promise, MutationObserver
      • Task queue: setTimeout, setInterval, 이벤트 핸들러
  • Event Loop (이벤트 루프)
    • 콜스택이 비었는지 확인
    • 비면 queue에서 작업을 하나 꺼내서 콜스택으로 이동시키는 존재

그림


꼬리질문

  1. Microtask와 Task의 차이는 무엇인가요?
    • Microtask(Promise, MutationObserver)는 Task Queue(setTimeout, DOM 이벤트)보다 우선적으로 실행됩니다.
    • 콜스택이 비는 순간, 먼저 Microtask Queue를 모두 비운 다은 Task Queue를 처리합니다.
  2. setTimeout 0ms가 바로 실행되지 않는 이유는?
    • setTimeout의 지연시간은 최소 보장 시간이 아니라, “일단 Task Queue에 널어달라는 요청”일 뿐입니다.
    • 콜스택이 비어야 이벤트 루프가 큐에서 콜백을 가져올 수 있기 때문에 0ms라도 즉시 실행되지 않습니다.
  3. fetch()는 왜 Web API에서 처리되나요?
    • JS 엔진은 싱글 스레드라 네트워크 I/O를 처리할 수 없습니다.
    • 따라서 fetch 요청은 브라우저의 Web API가 처리하고, 응답 완료 후 Promise를 Microtask Queue에 넣습니다.
  4. 이벤트 루프는 자바스크립트 엔진의 일부인가요?
    • 아닙니다. 이벤트 루프는 JS엔진(V8)이 아니라 브라우저 환경(또는 Node.js 런타임)이 제공하는 구조입니다.
    • JS 엔진은 오직 코드 실행(Call Stack)만 담당합니다.

참고 블로그

https://inpa.tistory.com/entry/%F0%9F%94%84-%EC%9E%90%EB%B0%94%EC%8A%A4%ED%81%AC%EB%A6%BD%ED%8A%B8-%EC%9D%B4%EB%B2%A4%ED%8A%B8-%EB%A3%A8%ED%94%84-%EA%B5%AC%EC%A1%B0-%EB%8F%99%EC%9E%91-%EC%9B%90%EB%A6%AC

답변

this는 함수가 호출될 때 자신이 속하게 될 객체를 가리키는 특별한 키워드입니다.
함수의 선언 위치에 따라 스코프가 정적으로 결정되는 렉시컬 스코프와 달리, this는 함수가 ‘어떻게’, ‘어디서’ 호출되었는지에 따라 동적으로 바인딩 되는 것이 특징입니다. 따라서 같은 함수라도 호출 방식에 따라 this가 가리키는 객체는 달라집니다.

키워드 설명

  • this는 렉시컬 스코프가 아니다.
    • 스코프는 선언 위치로 결정
    • 하지만 this는 호출 시점에 결정 → dynamic binding
  • this 바인딩 4가지 규칙
    1. 기본 바인딩 (Default Binding)
      • 그냥 func() 호출
      • non-strict → window
      • strict → undefined
    2. 암시적 바인딩 (Implicit Binding)
      • obj.func()처럼 객체가 “호출 주체”일 때
      • this = obj
    3. 명시적 바인딩 (Explicit Binding)
      • call , apply , bind 로 this를 강제 지정
      • call/apply → 호출 시점에만 적용
      • bind → this가 영구적으로 고정된 새로운 함수 반환
    4. new 바인딩 (Constructor Binding)
      • new Foo()
      • this는 새로 생성된 인스턴스를 가리킴
  • 화살표 함수의 this(Lexical this)
    • 화살표 함수는 자신만의 this를 가지지 않음
    • 따라서 선언된 위치의 상위 스코프 this(lexical this)를 그대로 사용
    • 호출 방식(call/apply/bind)으로도 바뀌지 않음
  • setTimeout 내부에서 this가 깨지는 이유
    • 일반 함수 사용 시, 콜백을 브라우저가 단독 함수 호출(callback())형태로 실행
    • 화살표 함수 사용 시, this는 say()의 this = user로 고정

자료

우선순위 규칙 예시
1 new 바인딩 new Foo()
2 bind 바인딩(명시적) foo.bind(obj)
3 call/apply 바인딩(명시적) foo.call(obj)
4 암시적 바인딩 obj.foo()
5 기본 바인딩 foo()

꼬리질문

  1. this는 렉시컬 스코프인가요?
    • 아니요.
    • 자바스크립트의 this는 렉시컬 스코프가 아니라, 호출 방식에 따라 동적으로 결정되는 값입니다
    • 렉시컬 스코프는 선언 위치로 스코프가 고정되지만, this는 어떻게 호출되었는지에 따라 달라집니다.
  2. 화살표 함수는 왜 lexical this를 갖나요?
    • 화살표 함수는 자신만의 this 바인딩을 만들지 않도록 설계된 문법입니다.
    • 따라서 호출 방식과 관계없이, 선언된 위치의 상위 스코프 this를 그대로 사용합니다.
    • 이것은 콜백 내부에서 this가 자주 깨지던 문제를 해결하기 위한 ES6의 의도입니다.
  3. setTimeout 안에서 this가 왜 window로 떨어지나요?
    • 일반 함수로 콜백을 전달할 경우, 브라우저(Web API)가 이 콜백을 단독 함수 호출 형태로 실행하기 때문입니다.
    • 단독 호출은 기본 바인딩 규칙을 적용하므로, this는 window(또는 strict 모드에서는 undefined)가 됩니다.
    • 이를 방지하기 위해 화살표 함수나 bind를 사용해 this를 고정할 수 있습니다.

답변

클로저는 함수가 선언될 때의 렉시컬 스코프(외부 변수)를 기억하고, 그 함수가 스코프 밖에서 실행되더라도 그 변수에 접근할 수 있는 기능입니다.

키워드 설명

  1. 자바스크립트는 렉시컬 스코프(정적 스코프)를 사용한다.
    • 함수가 정의된 위치를 기준으로 스코프가 결정됨
    • 실행 위치가 아니라 선언된 위치가 핵심
  2. 함수는 자신이 선언된 스코프를 기억한다.
    • 내부 함수가 외부 함수의 변수에 접근 가능
    • 외부 함수가 종료된 후에도 그 변수들이 “사라지지 않음”
  3. 이 매커니즘을 클로저라고 한다.
    • 실행 컨텍스트가 종료되더라도 내부 함수가 참조하고 있다면 GC로 지워지지 않고 유지됨

예시 코드

function outer() {
    let count = 0;            // 외부 변수

    return function inner() {
        count++;
        console.log(count);     // 외부 변수 사용
    }
}

const counter = outer();
counter(); // 1
counter(); // 2
counter(); // 3
  • outer()는 이미 실행이 끝났지만
  • inner()가 count를 계속 기억하고 있기 때문
  • 즉, inner가 외부 스코프(outer)를 계속 유지 → 클로저

꼬리질문

  1. 렉시컬 스코프란 무엇인가요?
    • 렉시컬 스코프는 함수가 호출되는 위치가 아니라, ‘선언된 위치’를 기준으로 스코프가 결정되는 방식입니다.
    • 자바스크립트는 렉시컬 스코프를 사용하기 때문에 클로저가 가능합니다.
  2. 클로저의 단점은 무엇인가요?
    • 클로저는 외부 변수를 계속 참조하므로, 사용이 잘못되면 메모리 해제가 지연되거나 불필요한 메모리 유지로 이어질 수 있습니다.
    • 즉, 메모리 누수 위험이 있다는 것이 단점입니다.
  3. 실무에서 클로저를 어디에 사용하나요?
    • 클로저는 함수가 만들어질 당시의 변수들을 계속 기억하게 해줘서, 이벤트, 비동기, 상태 관리, 데이터 은닉 같은 실무 상황에서 필수적으로 쓰입니다.
    • 예를 들어, 1) 버튼클릭 횟수 세기, 2) API 요청 시 “당시의 값”을 기억해야할 때, 3) private 데이터 만들기, 4) React의 setState 내부 동작에 사용됩니다.

답변

변수 선언은 변수를 만들고, 초기화는 메모리 공간을 확보해 기본값을 설정하는 과정이며,
할당은 그 변수에 실제 값을 넣는 과정입니다.

키워드 설명

  1. 변수 선언 (Declaration)
    1. “변수 이름을 자바스크립트 엔진에게 알려주는 것”
    2. 즉, 변수라는 존재를 정의하는 단계
  2. 변수 초기화 (Initialization)
    1. “선언된 변수에 메모리를 연결하고 기본값을 넣는 것”
    2. JS에서는 초기화 시 다음처럼 기본값이 들어간다.
      1. var → 선언 + 초기화가 함께 일어나며, 값은 undefined
      2. let / const → 초기화 단계가 선언과 분리되어 있고, 초기값이 설정되기 전까지는 TDZ(Temporal Dead Zone) 상태에 놓인다.
  3. 변수 할당 (Assignment)
    1. “초기화된 변수에 값을 넣는 것”

꼬리질문

  1. var / let / const에 따른 차이점이 무엇인가요?
    • var는 함수 스코프이며 선언과 초기화가 함께 호이스팅되어 undefined로 접근 가능합니다.
    • 반면 let과 const는 블록 스코프를 가지며 선언만 호이스팅되고 초기화되기 전까진 TDZ에 있어 접근이 불가능합니다.
    • 또한 let은 재할당이 가능하지만 const는 재할당이 불가능하고, 선언 시 반드시 초기값이 필요합니다.
  2. TDZ(Temproal Dead Zone)란 무엇인가요?
    • TDZ는 let / const 변수가 초기화되기 전에 접근할 수 없는 구간입니다.
    • 엔진은 변수를 호이스팅하지만 초기화되기 전까진 실제 사용할 수 없습니다.
  3. 호이스팅(Hoisting)이란 무엇인가요?
    • 호이스팅은 JS 엔진이 변수와 함수를 스코프 최상단에 끌어올리는 동작처럼 보이는 현상입니다.
    • var는 선언 + 초기화가 함께 호이스팅되어 접근이 가능하지만, let / const는 선언만 호이스팅되고 초기화 전까지는 TDZ에 있어 접근이 불가능합니다.
    • 접근 시에는 ReferenceError가 발생합니다.
  4. const로 선언한 객체의 값은 왜 변경 가능한가요?
    • const는 변수의 ‘재할당’을 막는 것이지, 객체 내부의 ‘속성 변경’을 막는 것이 아닙니다.
    • 객체는 참조(reference)로 관리되기 때문에, 참조 자체가 바뀌지만 않으면 내부 값은 변경 가능합니다.
    • 확장 설명:
      • const는 “변수 바인딩(참조)”을 고정
      • 객체는 heap 메모리에 실제 데이터가 저장
      • const 변수는 heap의 그 위치(참조)를 고정하는 것
      • 내부 필드는 그 위치 안에서 변경 가능

답변

자바스크립트는 웹 브라우저에서 동작하도록 만들어진 고수준의 인터프리터 기반 언어입니다.
동적 타입을 사용하고 함수형, 객체지향 등 멀티 패러다임을 지원합니다.
단일 스레드 기반이지만 이벤트 루프를 통해 비동기로 동작합니다.
현재는 Node.js 환경 덕분에 브라우저뿐 아니라 서버와 모바일 개발까지 확장된 범용 언어입니다.

키워드 설명

  1. 고수준(High-Level) 언어
    1. 메모리 관리나 하드웨어 세부사항을 신경 쓰지 않고 프로그래밍 가능
  2. 동적 타입(Dynamically Typed) 언어
    1. 변수의 타입이 런타임에 결정됨
    2. let a = 10; a = 'text'; 이런 코드 가능
  3. 인터프리터 기반(비컴파일) 언어
    1. 코드를 브라우저 엔진(V8 등)이 바로 해석하여 실행
    2. 빌드 없이 빠르게 실행되는 특징
  4. 멀티 패러다임 지원
    1. 절차적 프로그래밍
    2. 객체지향(OOP)
    3. 함수형 프로그래밍(FP)
    4. → 현대 JS는 함수형 + 선언적 스타일을 많이 사용
  5. 단일 스레드 기반 + 비동기 이벤트 루프 모델
    1. JS는 싱글 스레드
    2. 하지만 비동기는 이벤트 루프가 처리하여 성능 향상
  6. 브라우저를 위한 언어 → 지금은 범용 언어
    1. 원래는 웹페이지 동적 UI를 위해 태어남
    2. 그러나 현재는 다음 영역까지 확장
      1. Node.js (백엔드)
      2. React Native(모바일 앱)
      3. Electron (데스크톱 앱)
      4. IoT
      5. 서버리스

꼬리질문

  1. 왜 자바스크립트는 싱글 스레드인가요?
    • 💡 자바스크립트는 브라우저 환경에서 UI 조작을 안전하게 하기 위해 싱글 스레드 모델을 채택했습니다.
    • 💡 여러 스레드가 동시에 DOM을 변경하면 일관성과 성능 문제가 발생할 수 있기 때문입니다.
  2. 자바스크립트의 비동기는 어떻게 동작하나요?
    • 💡 자바스크립트는 싱글 스레드이지만, 브라우저나 Node.js의 백그라운드가 비동기 작업을 처리합니다.
    • 💡 완료된 콜백을 이벤트 루프가 큐에서 꺼내 콜스택으로 넣는 방식으로 비동기를 구현합니다.
      • JS 엔진 (Call Stack)
        • 자바스크립트 코드 자체를 실행하는 스레드(싱글)
      • Web APIs / Node APIs
        • setTimeout, fetch, DOM 이벤트 등을 백그라운드에서 처리
        • JS 엔진이 아님
      • Callback Queue (Task Queue / Microtask Queue)
        • 비동기 작업이 완료되면 콜백이 큐로 이동
        • Microtask: Promise then
        • Macrotask: setTimeout 등
      • Event Loop
        • 콜스택이 비는 순간, 큐에서 콜백을 꺼내 실행
        • “JS는 비동기를 스레드가 아니라 스케줄링으로 처리한다”는 의미
  3. 자바스크립트는 인터프리터 언어인데, V8은 JIT컴파일을 사용하는 이유는?
    • 💡 전통적으로 자바스크립트는 인터프리터 언어였지만, 실행속도를 높이기 위해 현대 엔진(V8 등)은 코드를 인터프리터로 읽은 뒤, 반복 사용되는 코드를 JIT 컴파일러로 기계어로 변환합니다.
    • 💡 결과적으로는 인터프리터+컴파일러 방식을 혼합해 성능을 최적화합니다. 
      • 초창기 JS 엔진: 인터프리터 방식 → 속도 느림
      • V8 구조:
        • Ignition(인터프리터): 코드를 빠르게 실행
        • TurboFan(JIT 컴파일러): 자주 실행되는 코드를 최적화하여 기계어로 컴파일
      • 최적화를 위한 히든클래스, 인라인 캐싱 같은 기법 사용
        • → 속도 개선 극대화

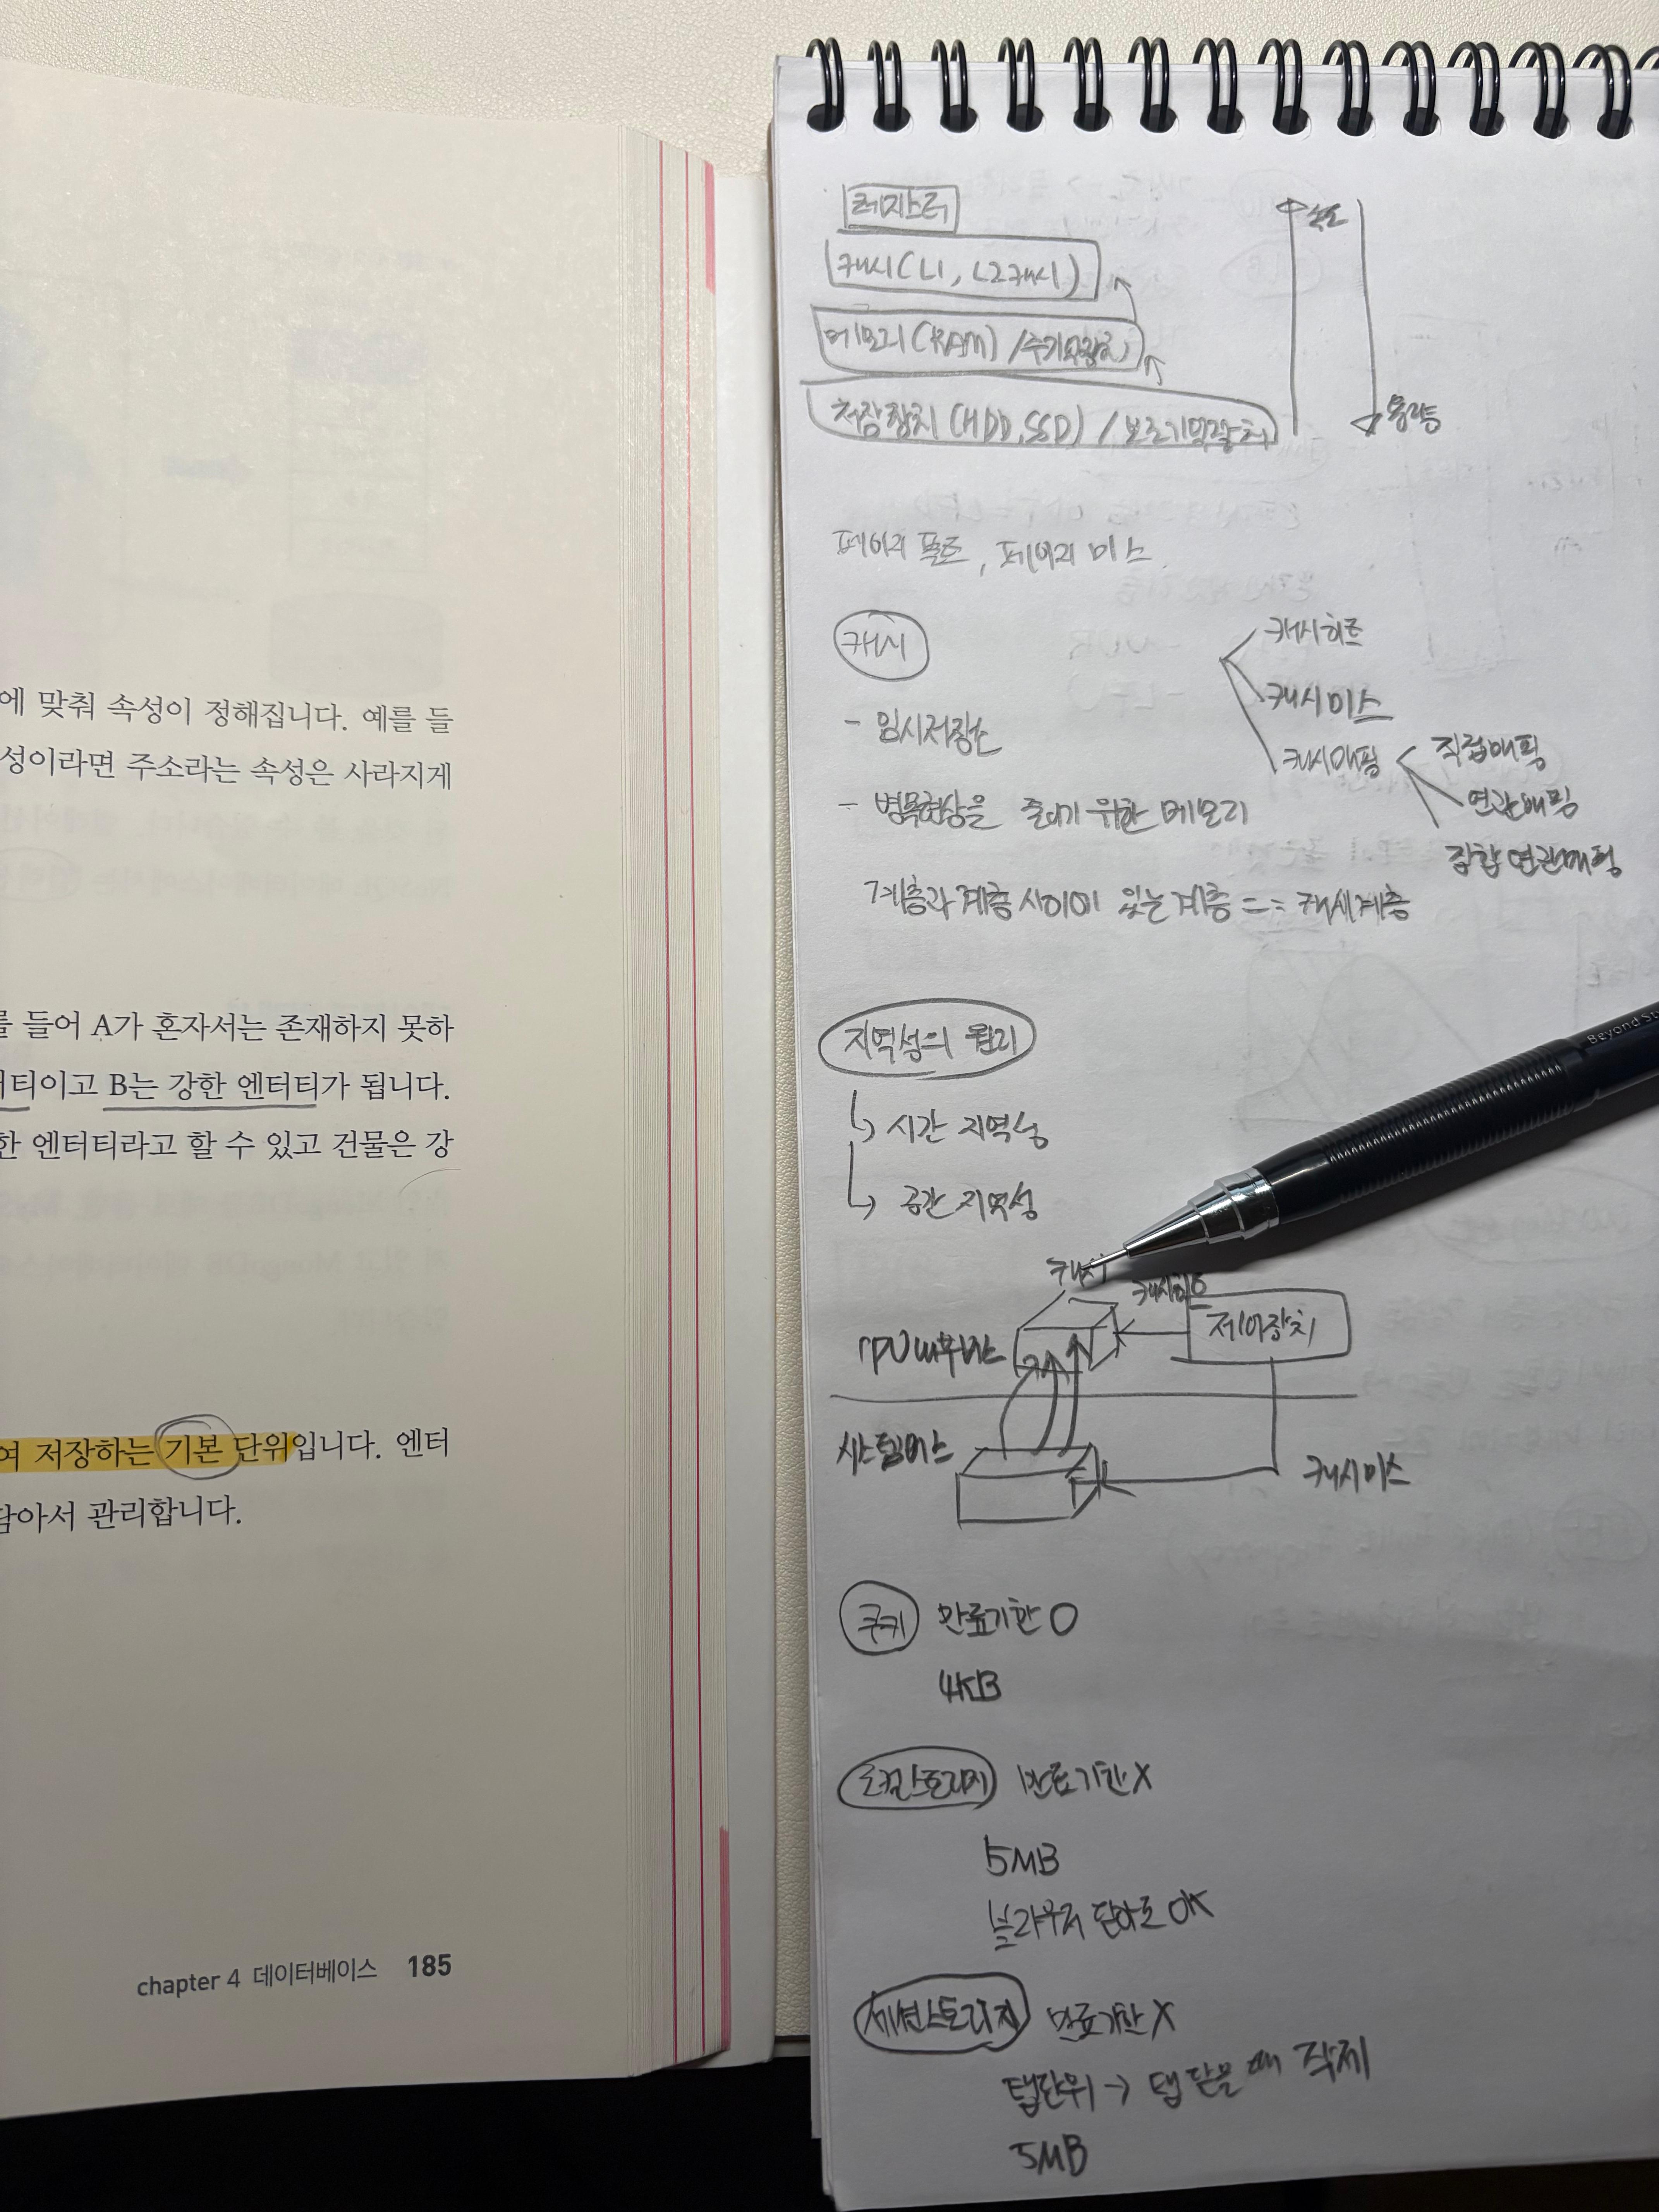
CPU, 메모리, 디스크, 브라우저 캐시, Redis 같은 DB 캐시까지…

다 따로 노는 개념처럼 보이지만, 사실 전부 “느린 것 대신 빠른 곳에 미리/자주 저장해두자”는 같은 아이디어에서 출발한다.

이번 글에서는:

  • 메모리 계층 구조
  • 캐시와 지역성의 원리
  • 캐시 히트 / 캐시 미스
  • 캐시 매핑 방식
  • 웹 브라우저의 캐시 (쿠키, localStorage, sessionStorage)
  • 데이터베이스 캐싱 계층 (Redis)

까지 한 번에 묶어서 정리해본다.


1. 메모리 계층 구조: 왜 계층이 필요할까?

CPU는 엄청 빠른데, 메모리는 그 정도로 빠르지 않다.

디스크나 네트워크까지 가면 더더욱 느려진다. 그래서 시스템 구조는 이렇게 생겼다:

레지스터 (Register)
       ↓
L1 캐시
       ↓
L2 캐시
       ↓
L3 캐시
       ↓
메인 메모리 (DRAM)
       ↓
SSD / HDD
       ↓
원격 스토리지, DB, 네트워크

아래로 갈수록:

  • 속도는 느려지고
  • 용량은 커지고
  • 비용은 싸진다

이 계층 구조 덕분에, 자주 쓰는 데이터는 위쪽(빠른 계층)에 두고,

덜 자주 쓰는 데이터는 아래쪽(느린 계층)에 둬서 속도와 비용을 동시에 잡는 전략을 쓴다.


2. 캐시(Cache)란? — “위 층에 두는 복사본”

캐시는 한 줄로 정리하면:

느린 저장장치(메모리/디스크/네트워크)에 있는 데이터를 빠른 저장장치에 “복사본”으로 보관해두는 구조

CPU 입장에서는:

  • 캐시 = 메모리의 복사본

웹 브라우저 입장에서는:

  • 캐시 = 서버 리소스(HTML, JS, 이미지 등)의 복사본

DB 입장에서는:

  • 캐시 = 디스크나 원격 DB에 있는 데이터의 복사본 (예: Redis)

공통점:

자주 쓰는 것을 더 빠른 공간에 미리 올려둠으로써 평균 접근 시간을 줄인다.


3. 지역성의 원리: 캐시가 먹히는 이유

캐시는 “운 좋으면 빠르고, 아니면 말고”가 아니다.

CPU나 프로그램이 실제로 “지역성(Locality)” 이라는 패턴을 보이기 때문에 잘 먹힌다.

3-1. 시간 지역성 (Temporal Locality)

한 번 접근한 데이터는 가까운 미래에 또 접근될 가능성이 크다.

예:

  • for 루프 안에서 같은 변수 계속 사용
  • 최근에 사용한 함수가 다시 호출
  • 스택 프레임, 전역 변수, 카운터 등

그래서 “최근에 사용한 것들을 캐시에 남겨두자”는 전략이 의미가 있다.

3-2. 공간 지역성 (Spatial Locality)

어떤 주소에 접근했다면, 그 주변 주소에도 곧 접근할 가능성이 크다.

예:

  • 배열 순회 arr[0], arr[1], arr[2] …
  • 연속된 구조체 접근
  • 코드도 메모리에 연속적으로 올라가 있으므로, 인근 명령어들을 순차 실행

그래서 캐시는 한 번에 한 워드만 가져오지 않고, 그 주변까지 한 덩어리(블록 또는 라인)로 가져온다.

3-3. 요약

  • 시간 지역성: “다시 쓸 가능성이 크다 → 캐시에 오래 보관”
  • 공간 지역성: “옆 주소도 쓸 가능성이 크다 → 주변을 같이 가져오자”

CPU 캐시, 디스크 캐시, DB 캐시, 웹 캐시 모두 이 개념을 활용한다.


4. 캐시 히트와 캐시 미스

캐시를 쓴다는 건 결국 다음 둘 중 하나다.

✔ 캐시 히트(Cache Hit)

CPU(또는 프로그램)가 찾는 데이터가 캐시에 이미 있는 경우

  • CPU: L1/L2/L3 캐시에서 찾음
  • 브라우저: 로컬 캐시에 HTML/JS/이미지 이미 있음
  • Redis: 메모리에서 바로 해당 키를 찾음

→ 매우 빠르다.

→ CPU 캐시의 경우, CPU 내부 버스만 타고 끝나기 때문에 레이턴시가 극도로 짧다.

✔ 캐시 미스(Cache Miss)

캐시에 없어서 더 아래 계층(느린 계층)까지 내려가서 데이터를 가져와야 하는 경우

CPU 입장에서는:

  • 캐시에 없음 → 메인 메모리(DRAM)까지 가야 함 → 시스템 버스를 타고 왕복 → 느림

DB 입장에서는:

  • Redis에 없음 → 디스크 기반 RDB까지 조회 → 느림

웹 브라우저 입장에서는:

  • 브라우저 캐시에 없음 → 서버까지 HTTP 요청 → 느림

그래서 시스템들은 최대한 히트율(hit ratio) 을 올리려고 한다.


5. 캐시 매핑 방식 (CPU 캐시 관점)

CPU 캐시에서 데이터가 “어디에 놓이는가?” 를 결정하는 규칙이 캐시 매핑(Cache Mapping)이다.

5-1. Direct Mapped Cache

메인 메모리의 특정 블록은 캐시의 딱 한 위치에만 저장 가능

  • 장점: 구현이 단순, 빠름
  • 단점: 충돌이 많을 수 있음 (자주 쓰지만 같은 인덱스를 공유하는 데이터들)

5-2. Fully Associative Cache

메모리 블록이 캐시 어느 곳에나 저장될 수 있음

  • 장점: 충돌 최소화
  • 단점: 어디에 있는지 찾기가 복잡 (비싸고 느림)

5-3. Set Associative Cache (실제 많이 사용)

캐시를 여러 set으로 나누고,

각 set 안에서는 associative하게 배치 가능

  • 예: 4-way set associative
  • Direct와 fully associative의 타협안
  • 현대 CPU에서 가장 일반적인 방식

이 매핑과 더불어:

  • 어떤 블록을 버릴지(교체 정책: LRU, Random 등)
  • 쓰기 정책(write-back, write-through)

까지 합쳐져 캐시의 성능이 결정된다.


6. 웹 브라우저의 캐시: 메모리 계층의 “상위 레벨” 버전

웹 개발을 하다 보면 또 이런 캐시들이 등장한다:

  • HTTP 캐시 (브라우저가 리소스를 저장)
  • 쿠키(Cookie)
  • localStorage, sessionStorage

여기서 쿠키 / localStorage / sessionStorage는 좀 역할이 다르다.

6-1. 쿠키(Cookie)

  • 서버나 자바스크립트가 브라우저에 심는 작은 데이터 조각
  • 매 요청마다 HTTP 헤더에 실려서 서버로 전송됨
  • 주로 로그인 세션, 트래킹, 사용자 식별 등에 사용
  • 용량이 작음(수 KB 단위), 보안 이슈 있음(HTTP 전송)

쿠키는 “캐시”라기보다는 상태 유지용에 더 가깝지만,

“서버가 매번 다시 묻지 않기 위해” 정보를 로컬에 저장한다는 점에서 넓은 의미의 캐시로 볼 수도 있다.

6-2. localStorage

  • 도메인별로 영구 저장되는 키-값 저장소
  • 브라우저를 껐다 켜도 남아있음
  • JS에서 localStorage.setItem(key, value) 로 접근
  • 서버에 자동으로 전송되지 않음 (쿠키와 가장 큰 차이)

예:

  • 다크 모드 설정
  • 최근 본 상품 리스트
  • 사용자의 간단한 환경설정

6-3. sessionStorage

  • 탭 단위로 살아있는 저장소
  • 탭을 닫으면 사라짐
  • 페이지 리로드 시에는 유지됨

예:

  • 특정 페이지에서만 쓰는 임시 상태
  • 탭마다 분리되어야 하는 데이터

6-4. 진짜 “웹 캐시” — HTTP 캐시

여기까지 오면 진짜 캐시다운 캐시가 나온다.

  • HTML, CSS, JS, 이미지 파일 등을 브라우저가 로컬 디스크/메모리에 저장
  • 다음에 같은 URL에 접근할 때,
    • 만료 안 됐으면 그대로 사용 (Cache Hit)
    • 만료됐거나 조건부 요청시 서버에 재검증

이건 CPU–메모리 캐시와 거의 동일한 개념이다:

  • 원본: 서버의 리소스
  • 복사본: 브라우저 로컬 캐시
  • 목표: 네트워크 왕복 줄이기

7. 데이터베이스의 캐싱 계층 (Redis 등)

백엔드 쪽으로 가면 또 하나의 “메모리 계층” 구조가 보인다.

일반적인 구조:

CPU / 애플리케이션 (서버 코드)
          ↓
       Redis (인메모리 캐시, key-value)
          ↓
   RDBMS (MySQL, PostgreSQL 등, 디스크 기반)
          ↓
   디스크 / 스토리지

역시 똑같다.

  • 자주 읽히는 데이터는 메모리에 띄워놓고 빠르게 제공
  • 덜 자주 쓰이거나, 영구 보관이 필요한 데이터는 디스크 기반 DB에 저장

7-1. Redis의 역할

Redis는:

  • 메모리 기반 key-value 저장소
  • 읽기·쓰기 속도가 매우 빠름
  • 세션 관리, 랭킹, 카운터, 토큰 저장 등에서 자주 사용

예:

  • GET user:123 → Redis에서 바로 나오면 DB까지 안 내려감 → Hit
  • Redis에 없으면 → MySQL 쿼리 → 결과를 Redis에 저장 → Miss 후 Fill

이 구조를 통해:

  • DB 부하 분산
  • 응답 시간 단축
  • 스케일 아웃 용이

결국 DB도 자체적으로 “메모리 계층”을 쌓는 것이다.


8. 전체 그림: 모든 레벨의 캐시를 한 번에 묶어 보면

조금 과장해서 그려보면, 요즘 서비스 하나를 띄웠을 때 메모리 계층은 이렇게 된다:

[CPU 레지스터]
   ↓
[CPU 캐시 (L1/L2/L3)]
   ↓
[메인 메모리 (프로세스 힙/스택)]
   ↓
[OS 페이지 캐시, 버퍼 캐시]
   ↓
[DB 캐시 (MySQL InnoDB Buffer Pool 등)]
   ↓
[Redis 같은 인메모리 캐시]
   ↓
[디스크 기반 RDBMS 데이터 파일]
   ↓
[원격 스토리지, 백업, 데이터 레이크 …]

+ 클라이언트 쪽:
[브라우저 메모리]
   ↓
[브라우저 HTTP 캐시]
   ↓
[localStorage / sessionStorage / 쿠키]
   ↓
[네트워크 요청 → 서버]

위에서 아래로 내려갈수록:

  • 속도 ↓
  • 용량 ↑
  • 비용 ↓
  • 영속성 ↑

그 사이사이에 “캐시”라는 계층을 끼워넣어 성능을 끌어올리는 구조다.


9. 마무리 요약

  • 메모리 계층: 빠른 것(작고 비싸다)부터 느린 것(크고 싸다)까지 층을 쌓아둔 구조
  • 캐시: 느린 계층의 복사본을 빠른 계층에 두는 구조
  • 지역성의 원리 덕분에 캐시는 잘 먹힌다
    • 시간 지역성: 최근 쓴 걸 또 쓴다
    • 공간 지역성: 근처도 같이 쓴다
  • 캐시 히트/미스: 히트면 빠른 계층에서 해결, 미스면 아래로 내려가야 해서 느림
  • 캐시 매핑: 메모리 블록이 캐시에 어디에 배치되는지 결정(direct / associative / set-associative)
  • 웹 브라우저 캐시: HTTP 캐시 + 쿠키/localStorage/sessionStorage라는 다양한 형태로 존재
  • DB/Redis 캐시: DB 앞에 메모리 캐시 계층을 두어 읽기 성능을 끌어올리는 구조

결국 로우레벨(CPU 캐시)부터 하이레벨(웹, DB)까지 같은 아이디어가 반복해서 등장한다.


목표: Redis는 아직 사용해보지 않아서, 프로젝트에 적용해보려고 한다. 얼마나 빨라지려나!? 😬

오늘의 공부

'CS' 카테고리의 다른 글

[CS-운영체제] 컴퓨터의 요소  (1) 2025.11.17
[CS-운영체제] 운영체제의 역할과 구조  (0) 2025.11.16

+ Recent posts